ラベル TensorFlow の投稿を表示しています。 すべての投稿を表示

2021年7月13日火曜日

TensorFlow2(6)4章 写真分類

TensorFlowしよう!
人類滅亡を企む機械学習ビギナーの皆さんこんにちは.

コンピュータが登場して50年ってところでしょうか? その動作を激しく単純化すればシーケンサだと思います.8bit CPUもクラウドサーバーも言ってしまえばシーケンサ.機械学習はどうかというと、入出力仕様がblack-boxの謎物体ですからコンピュータサイエンス的には異端者なんだろうな.決定論的なマシンが非決定論的なマシンを産み出すとはこれ如何に?

さて、「TensorFlow2プログラミング実装ハンドブック」第4章の後半では写真を10分類するsample programが紹介されています.
28x28の画像+正答が6万個用意されていて、それをニューラルネットに突っ込みます.3分類ニューラル君と違う点は、
 ・入力が28x28=784次ベクトルに巨大化
 ・出力が10本
 ・隠れ層の活性化関数がダイオード特性(整流)になる

実はこれらの他に巨大な違いが在って、云うまでもなくそれは「偏微分の式」なわけですが、そんな面倒な事を知る必要はないです.微分も更新もTensorFlow/Kerasにお任せの放置プレイでよかよか.

学習させたニューロン君に本番の分類をさせると当然ながら一部は誤ります.
「間違えた写真を表示させたろ」と思ったのですが、PythonやTensorFlowの扱いがよく判らんので上手く表示できてません.オブジェクト指向のsourceは読むのは楽なんだけど応用するのはかったるいなぁ.

かしこ

2021年7月10日土曜日

TensorFlow2(5)3分類ニューラルネットについて

TensorFlowしよう!
機械学習ビギナーの皆さんこんにちは.

「TensorFlow2プログラミング実装ハンドブック」第4章のsample programを眺めているところです.3つの山を認識してRGBに分類するニューラルネットです.
前回の2分類ニューラルネットと似た者ですが、大きく違うのは出力関数です.
出力関数にはいろいろありますが、いずれにも共通した特性は、ー∞~+∞までの入力を受け入れて、出力を0~1に圧縮するところです.
2分類ニューラルの出力関数はシグモイドという奴でした.シグモイドはこんな特性です.出力の0.5を境界に赤か青かの意味を持たせました.
3分類ニューラルネットの出力もシグモイド特性ですが、違うのはRGBの3本出てきます.そいつの出方がミソでして、
  {R,G,B}={0.7, 0.2, 0.1}       ←Rである可能性が高い
このように合計1に正規化されたRGBの確率で出てきます.「合計1に正規化された確率ベクトル」を出す関数をソフトマックスと呼びます.
2分類ニューラルネットと3分類ニューラルネットの違いは以上かな.
つまり、
 1)出力が1本→3本になる
 2)終段の出力関数がシグモイド→ソフトマックスになる
 3)重みWの個数が少し増える

ーーーー
TensorFlow2のsource codeは、キモの部分だけ抜粋するとこんな感じです.それなりに手順を踏んでる様子がわかると思います.
①ニューラルネットの定義
class MLP(tf.keras.Model):
    def __init__(self, hidden_dim, output_dim):
        super().__init__()
        self.l1 = tf.keras.layers.Dense(hidden_dim, activation='sigmoid')
        self.l2 = tf.keras.layers.Dense(output_dim, activation='softmax')
    def call(self, x):
        h = self.l1(x) 
        y = self.l2(h)
        return y
②損失関数の定義
cce = tf.keras.losses.CategoricalCrossentropy()
def loss(t, y):
    return cce(t, y)
③学習ルーチンの定義
def train_step(x, t):
    with tf.GradientTape() as tape:
        outputs = model(x)
        tmp_loss = loss(t, outputs)
    grads = tape.gradient( tmp_loss, model.trainable_variables)
    optimizer.apply_gradients(zip(grads, model.trainable_variables))
    train_loss(tmp_loss)
    return tmp_loss
④メインルーチン
model = MLP(2, 3)
for epoch in range(epochs):
    for step in range(steps):
        tmp_loss = train_step(x_[start:end], t_[start:end])

ところが、Kerasで同じニューラルネットを記述するとこんなに短くて済みます.KerasはTensorFlow2を簡単に使うラッパーです.
①ニューラルネット定義
model = Sequential()
model.add(Dense(2, activation='sigmoid'))
model.add(Dense(3, activation='softmax'))
②損失関数と学習ルーチンの定義
optimizer = optimizers.SGD(learning_rate=0.1)
model.compile(optimizer=optimizer, loss='categorical_crossentropy', metrics=['accuracy'])
③メインルーチン
history = model.fit( x, t, epochs=epoch, batch_size=batch_size, verbose=1, validation_split=0.2 )

なるほどKerasは便利だと評判になるわけですね.ニューラルネットの定義は階層の次数と階層の出力関数で決まる(らしい)ので、この2行で済んでしまうのはさもありなんです.
model.add(Dense(2, activation='sigmoid'))
model.add(Dense(3, activation='softmax'))

というわけで、ここまでで機械学習についてわたしが知り得たことは、、、
・Kerasは便利でいいや
・ニューラルネット構造を定義すればほぼ完了
・自動微分やバックプロパゲーションのprogrammingの必要なし
・教師データを食わせれば学習完了

かしこ

2021年7月3日土曜日

TensorFlow2(4)2分類ニューラルネットのsource codeを読んでみる

太平洋高気圧が北へ押しやった梅雨前線がちょうど日本列島の上にある今日も雨降り.屋外を通って木材を搬入すると濡れてしまうのでシャワールーム作りはお休みです.

てなわけで、雨降りでもやれるのはTensorFlowだけであります.

「TensorFlow2プログラミング実装ハンドブック」第4章のsource codeを見てゆきます.
でも、クラスの中で何やってるのかがさっぱりわからん......

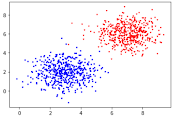
第4章前半で実装するのはこのニューラルネットです.xを2つの山に分類します.

In[1]: 2次元Xベクトルを1000個作る
ニューラルネットに投入するものです.
これだけで500個のベクトルを作れるのは便利でいいや.
   x1 = np.random.randn(500,2) + np.array([3, 2])
教師データも作っています.
   t1 = np.array([[0] for i in range(500)])

分布が2つの雲状になっているので、赤と青に分類するのがニューラル君にさせたい仕事です.

In[3]: 上の図のニューラルネットを定義する
MLPはmulti layer perseptronの略かな?
class MLP(tf.keras.Model):          Kerasから継承
    def __init__(self, hidden_dim, output_dim):        隠れ層2次元、出力層1次元として後で呼び出されることになる
        self.l1 = tf.keras.layers.Dense(hidden_dim, activation='sigmoid')  隠れ層L1
        self.l2 = tf.keras.layers.Dense(output_dim, activation='sigmoid')  出力層L2
    def call(self, x):     ニューラルネット本体
        h = self.l1(x)   隠れ層L1の計算
        y = self.l2(h)   出力層L2の計算
        return y    出力層L2を返す

たったこれだけでニューラルネットを定義できちゃうんだから便利でいいわ.
もっと層数が多かったり多次元だったりするニューラルネットを定義したければ、
    MLP(10,10,8,6,10,10,3,1)
などと記述すればいいんだろうなぁ.なんかスゲー便利じゃね?

なお、kerasというのは、TensorFlowを便利に使えるラッパーレイヤーです.より一層black boxに....

In[4]: 誤差計算を定義する
bce = tf.keras.losses.BinaryCrossentropy()      出来合いの誤差計算objectを流用
def loss(t, y):
    return bce(t, y)
tは赤青の教師フラグで0または1
yはニューラルネット出力で0~100%

BinaryCrossentropy()は内部で何をやっているのか?
sourceを読んだわけじゃないので概ね想像ですが、、、
Binaryというワードの意味するところは、t=0または1、すなわち赤青の2値分類に対応した誤差計算であると名乗っているんじゃないかと思います.
そして、tとyを材料にblack boxがやっている計算は、、、
教師データが10個あるとします.ゆえに正答tは10個です.Xも10個です.
それぞれに対してニューラルネット出力yも10個得られます.yは0~1のfloatです.下表では%で表しています.
tとyが誤差計算関数loss(t,y)に与えられますと返り値は-0.0005979です.(実際は対数で計算してるのかもしれませんが不明です)

この-0.0005979は何者なのかが重要です.
1番目: 正答は1です.ニューラル君は75%だと言ってる.>50%なのでニューラル君も1だと判定しました.おめでとう正解です.得点は75点です.
2番目: 正答は0です.ニューラル君は27%だと言ってる.<50%なのでニューラル君も0だと判定しました.おめでとう正解です.得点は100-23=73点です.
3番目: 正答は0です.ニューラル君は「96%だから絶対1だ」と主張しました.残念ですが大ハズレです.得点はたったの100-96=4点です.
10番目まで計算すると、得点(tとのマッチ度)が10個出てきます.10個の得点を掛け算したものが0.0005979です.さらに符号反転して-0.0005979です.
掛け算ですから、10個とも100点だったらloss()=-1で最高得点です.3番目みたいな「大外し」をしでかすと鬼の様に足を引っ張ってloss()=0に近づいてしまいます.
ニューラルネットは教師あり学習を積み重ねることによって、lossの最小化(-1に近づける)を図ります.

In[5]: ニューラルネット内部に隠れたwとbを1回だけ修正するルーチン
optimizer = tf.keras.optimizers.SGD(learning_rate=0.1)   修正object
def train_step(x, t):    修正ルーチン
    with tf.GradientTape() as tape:   内部状態を記録する謎のblack-box
        outputs = model(x)    ニューラルネットMLPのインスタンス
        tmp_loss = loss(t, outputs)     誤差を計算する
    grads = tape.gradient( tmp_loss, model.trainable_variables)    自動微分
    optimizer.apply_gradients(zip(grads, model.trainable_variables))    修正
    return tmp_loss     誤差を返して終了

W修正のキモはどうやって微分するの?ってことです.微分さえできてしまえば後はお茶の子さいさいですから.とするとGradientTapeが最重要ですがblack-boxでワケワカメ.
TensorFlow tutorialにGradientTapeの解説が少しあります.GradientTapeは内部計算の全てを記憶するそうです.またトップダウン型自動微分が実装されているとのこと.wikiの自動微分へリンクされていて、自動微分は数式微分でも数値微分でもないと書かれています.

自動微分とはなんぞやですが、ひら理解によると、合成関数の微分で順次解いてゆく計算手法で、ボトムアップ型自動微分は以下のような事をやっているみたいよ.
1)W111で偏微分したいとすると、ニューラルネットのW111~yまでを残して他は全部切り捨てる.そうしないと混ざってしまって偏微分にならないと思う.
2)u11=w111 x1 をw111で微分する   ②
3)sgd=sgd(u11) をu11で微分する     ③
4)u21=w211 sgd をw211で微分する    ④
5)y=sdg(u21) をu21で微分する      ⑤
6)微分=②③④⑤

個々の微分を実行するには、各変数の⊿が必要です.⑤の場合は⊿yと⊿u21が必要です.それはたぶん、1回過去の修正動作時のyやu21との差分を採用しているのだと思います.⑤=⊿y/⊿u21と計算すれば微分できたことになるんじゃね?

wikiによるとこのような自動微分は1960年代に最初の論文が出ているらしい.便利なことを考えてくれる人がいてよかったですね.

In[6]: いわゆるmain()がここ
model = MLP(2, 1)         隠れ2次元、出力1次元のニューラルネットを生成
for ~ next
        tmp_loss = train_step(x_[start:end], t_[start:end])     train_step()はIn[5]で記述した修正ルーチン

他のごちゃごちゃした物は割愛


何をやってるかだいたい想像ついた感じー.
自動微分というものを初めて知りました.
めんどくさいニューラルネット等の記述が簡単ポンで便利でよかよか.

かしこ

2021年6月30日水曜日

TensorFlow2(3)第4章ニューラルネット

寝ても起きてもテンソルテンソル!

いつものように入門書「TensorFlow2プログラミング実装ハンドブック」の通りに動かしています.わたしはPythonをほとんど知らないのでPythonのクラスのsourceを読んでも判らんので困っています.

第4章では初歩的なニューラルネットが登場します.W修正式の導出は第3章よりもややこしくなっています.ややこしくても原理は同じです.下図の出力に現れた誤差をWで偏微分しまくりです.

第4章は「ロジスティック回帰」という計算をニューラルネットでやる方法を説明しているのだけど、わたしはロジスティックとか回帰という言葉を知りません.統計用語でしょうか?
ともあれやろうとしていることはこうゆうことだと思います.
・N次元ベクトルデータXが無数にある
・Xをplotすると下図のように2つの山に分かれて分布しているとする
・Xに「赤」「青」という属性を与えて分類するのが最終目的
・その分類をニューラルネットの学習(勾配降下法)で最適化する
・Xの一部は教師データであり、赤青の正解を持っている

↓「勾配降下法」に依らずしても解く方法はあります.固有値ベクトルを求めて、固有値ベクトルを基底とする座標変換をして、原点より右側ならパターン赤、原点より左側ならパターン青、と分類するのでも構わないはずです.
そう考えるとこんな風に思います.
・ニューラルネットにベクトルXが入力され、Xの各要素に重みづけWが掛け算される
・Wもベクトルだから、Xに重みづけWを掛けるのは「XとWの内積」を計算するのと同じである
・Wはニューラルネットの学習が進むにつれて修正されてゆき最終的には固有値ベクトル(=基底)に収斂してゆくのだろう
・Wが基底ならば、XとWの内積は座標変換計算そのものである

もっとも、ニューラルネットには心が無いので、そんな手の込んだ計算をしているとは自覚してません.人間がWの修正式を適切に設計してニューラルネットに組み込んでやったから赤青判定が上手に働いてるだけです.
虚しいです.
ヒトがWの修正式を解いてあげて、ヒトがニューラルネットに実装してあげなくちゃいけません.ニューラルネットには自力で学習方法を模索する能力は無いんです.つまり機械学習とは「教師あり学習のオートメーション化」に過ぎません.虚しいです.

第4章の後半では、画像を靴・ズボン・シャツ・バッグ、、、などに分類するより複雑な例が解説されています.28x28pixの画像が784次元ベクトルXとしてニューラルネットへ入力されます.784次元空間に占めるズボンの配置を特定するようなWの修正式がヒトによってニューラルネットに組み込まれています.スケールは大きくても原理は赤青分類と同じです.虚しい.

次回はTensorFlow2のsourceを追ってみます.

かしこ

2021年6月21日月曜日

Tensorflow2(2)微分計算で立ち止まるわたくし

Tensor計算してますか? 添え字が多いのでわたしには出来ません.

いつものように入門書「TensorFlow2プログラミング実装ハンドブック」の通りに動かしています.PythonとJupyter NBの使い方をあまり判っていません.

まだ3章「勾配降下法」のところです.TensorFlowオブジェクトが判らんちんです.

勾配降下法について少し説明します.
excelグラフの「XY散布図」に近似関数を表示させる機能があるでしょう.あれをやる計算方法の一つが勾配降下法です.(他のやり方もあるのでexcelが勾配降下法を活用しているとは思ってません)

「近似関数を作る」とは「近似関数の誤差を小さくする」事で達成されます.
それには誤差を計算せないけません.誤差は2乗誤差を採用します.他の誤差を使っても勾配降下法は動くでしょうけど、2乗誤差は分散や標準偏差に則った数式になるのと、2乗を微分するのはさほど苦労しないからだろうねぇ.

2乗誤差とはこういう物です.
散布図のXYペアはたくさんあります.それらを(Xi,Yi)とします.
ここでは近似関数を最も簡単な Y = a X + b  とします.直線近似ですね.
aとbを最適化するのが勾配降下法の仕事です.
すると誤差は、ei = Yi - ( a Xi + b) と定義されます.近似バッチリならei=0になる.
2乗誤差は ei を2乗したものです.
ただし、XYペアはたくさんあるので個々の2乗誤差eiを全て足したものを「2乗誤差」として採用します.
(式1)

次に「aを最適化する」とは「2乗誤差が小さくなるようにaを修正する事」ですから、
  (式2a)
このようにaを修正すればOKです.0.01は少しづつ修正する意味があり、このa修正式を100回ぐらい繰り返せば最適なaになるだろうとの目論見です.
bの修正式も同様です.
  (式2b)
修正後のaとbを使って求め直したEは次第にゼロに近づいてゆくはずです.実際にはE=0にはならなくて、減少ペースがサチったところで計算を打ち切ります.

a修正式とb修正式に登場する偏微分はやってみれば案外簡単に(高校数学で)解けます.具体的な修正式はこうなります.この式を見ると、for-next文で書きやすい形式だと判るでしょう.またhard logicに実装するのも楽な形式です.
 (式3)
以上が勾配降下法のアバウトな考え方です.


書籍ではこの修正式を動かすsample programがTensorFlowオブジェクトを活用して書かれています.なのですがブラックボックス的でかな~りイミフです.
1)近似関数y=ax+bのサブルーチン
def model(x):
    y = a*x + b
    return y

2)2乗誤差関数のサブルーチン.式1を記述している
def loss(y_pred, y_true):
    return tf.math.reduce_mean(tf.math.square(y_pred - y_true))

3)近似値配列を生成
    y_pred = model(train_x_std) 

4)2乗誤差配列を生成
    tmp_loss = loss(y_pred, train_y_std)

5)偏微分、さっぱり判らないのがここ.
    gradients = tape.gradient(tmp_loss, [a, b])
gradientへ渡しているのは2乗誤差配列と微分変数のaとbのみ.式3を計算するのに材料が不足しているのは何故ですか?

6)aとbの修正.learning_rate は上で述べた0.01のこと.
    a.assign_sub(learning_rate * gradients[0])
    b.assign_sub(learning_rate * gradients[1])

いったい何をやってるんだろうねぇ?
TensorFlowオブジェクトのソースを読む気はありません.
想像するに、式3の処理をやってるのでは無いんじゃないかね?
式2の処理を数値演算的にやってるのではないかな?
  (式2a)
  (式2b)
すなわち、TensorFlowオブジェクトにはloop各回のE,a,b,x,yのすべてがwork areaに記録されていると仮定する.そして微分の代わりに差分で計算しているんじゃないだろうか? この式のように.
  (式2’)
LSIにhard logicで実装するのならこのようなメモリを喰う実装はしないものですが、リソースリッチなPCならこういう実装もありなのでしょう.汎用性が高まって便利だし.


↓sample programをいじって2次関数近似にしてみました.なんかいい感じ~

小さなことをコツコツと.

かしこ

2021年6月20日日曜日

Tensorflow2(1)はじめます

Tensorflowしよう!

入門書を買いました.著者が外国人なのでO'Reillyの書籍みたいなとっつきにくい内容かと思ったのですが、本屋で中身を確認して納得して買いました.各種toolの名称すら知らない初心者がtoolをインストするところから手ほどきを受けるのに役立ちます.

各種toolについて説明しましょう.

Python
これは説明するまでもないでしょう.簡単に使えるけど動作速度はのろいです.

Jupyter Notebook
Pythonをインタラクティブに使える仮想環境.
Notebookという名前からは、windows画面上に仮想desktopが表示されるのかなと思ったら違いました.
windows上に窓が開くのはその通りなのですが、窓の使い勝手はまるで「mathematicaのインターフェース」です.手打ちで1+2とかできるあの環境です.機械学習であれにまた出会うとは思ってませんでした.

Anaconda
Python開発のための仮想環境パッケージの一つと思えばいいんじゃね?
Jupyter NotebookはAnacondaの中に含まれているので、本書で最初にやるのはAnacondaのインストールである.(HDDを3GBも喰う)

Anaconda Navigatorを起動して、Pythonを動かす仮想環境を作る.
デフォではbaseという仮想環境が存在する.Anaconda Navigatorの表示を見た印象ではやたら多くのライブラリがbaseにインストされている模様.
自分専用の仮想環境(hiratest1)を作る.hiratest1にはbaseよりも遥かに少ないライブラリしかインストされていない模様.わたしが聞いた事のあるものはpython, pip, vc, vs2015_runtime, openssl ぐらいかな.

この後でnumpyライブラリを追加しますが、軽くトラブル発生.numpyがlistされません.「update indexボタン」を押したらnumpyが見えるようになりました.

さらにJupyter Notebookをインストします.
これでやっとJupyter Notebookが動くようになりました.chromeのタブとして開きます.mathematicaのな~んか使い慣れないインターフェースの始まりです.

この後は、不慣れなPythonの使い方に慣れなくちゃいけません.

ここまでで入門書の第2章が終わりです.実はまだTensorFlowはインストされていません.

Keras
TensorFlow APIそのものよりも直感的に使えるようにしたラッパー.使いやすいので人気になったためTensorFlow2ではKerasもAPIとして正式採用された.
第2章までではまだKerasを使う段階には至っていません.

ーーーー
第3章からは、いよいよTensorFlowが始まります.

最初にTensorFlowをインストします.

そして「最小2乗法」「勾配降下法」を実装して動かすという初歩的な勉強が始まります.

先は長いです.

かしこ

2021年6月11日金曜日

Tensorflow2やってみます

皆さんこんにちは.座右の銘は「現物合わせ」、ヒラサカです.

さて、ヒラサカの専門は次のうちどれでしょう?
アナログ回路設計、デジタル回路設計、信号処理、にわかAVマニア、似非ソフト書き、リフォーム、アニメ、麻雀、3Dプリンター、カフェのマスター、洋酒、カレーライス、動物愛護、右翼、ブロガー

答えは、、、信号処理です.一番お金を稼いだのは信号処理だからそれが専門と言ってよろしかろう.

そして、今時の信号処理と言えば機械学習ってのが相場でしょう.

googleが機械学習ライブラリのTensorflowというのをリリースしています.お手軽にはpythonで動かすらしく、便利そうなので味見してみようと思います.

ところが、netを徘徊しても用語がさっぱりわかりません.
Colab、pip、docker、Keras、Jupyter、、、
なんだこの隠語は? toolの名称らしいのですが唐突にいくつも繰り出されて困ってしまいます.

このままnetを徘徊してても埒が明かんと思ったので、珍しく入門書を買いました.謎の隠語を回避できると期待します.

3年ぐらい前だったか、機械学習の本を読みました.機械学習を上手に行うには次の様にニューラルネットワークを設計しなくちゃいけません.
1)畳み込みフィルタを設ける
2)同フィルタの出力を二値化する適切な関数を選ぶ
3)二値化データを適宜切り捨てる
4)123を多層化する  =ニューラルネットワーク
5)1234をいろいろ変えて、うまく学習できるニューラルネットワークを経験的に決める
という感じでした.

なので例えば手書き数字認識をするに適したニューラルネットワーク構造はどうたらこうたら、、、という論文が在ったりするわけです.

大雑把にいえば、優秀なニューラルネットワークをカット&トライで決めるセカイです.でもそれはわたしの期待と違いました.人間の脳の発育過程では、赤ちゃんの頃は無意味でランダムに結線されたニューラルネットワークが在り、成長するにつれて不要な結線が消滅し有意味な結線だけが残ると云われます.そんな成長過程をも再現してくれるのが機械学習/深層学習なのだろうとの期待は崩れ去りました.それで機械学習への興味が薄れていたんです.

Tensorflowは名前がカッコイイので再度トライしてみようと思います.

連載になるかどうかは不明です.

#エッジコンピューティングで機械学習、果てはAIへ進化などという夢が語られますが、計算パワー的にキツいんじゃないかなぁ.Jetson Nanoを試してみたくはありますけど、もう少し安価だと嬉しいかな.安いGPUを買ってCUDAはやるかも.

かしこ